kaggle 필사 스터디 6주차에는 'Zillow's Home Value Prediction' 이라는 주제로 학습했습니다.
sudalairajkumar의 커널을 중심으로 공부하였으며, 전체 코드는 아래에서 확인할 수 있습니다.
https://www.kaggle.com/sudalairajkumar/simple-exploration-notebook-zillow-prize
Simple Exploration Notebook - Zillow Prize
Explore and run machine learning code with Kaggle Notebooks | Using data from Zillow Prize: Zillow’s Home Value Prediction (Zestimate)
www.kaggle.com
온라인 부동산 데이터베이스 회사인 'Zillow' 에서는 몇 백만 가지의 통계학적 머신러닝 모델을 이용해 부동산 값을 예측합니다.
-
이 competition에서는 집 값 자체를 예측하는 모델이 아닌, 예측값과 실제 값의 오차를 최소화하는 모델을 만드는 것이 목표입니다.
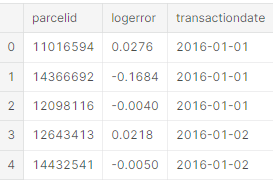
그렇기 때문에, train set에도 target 값으로 log error가 주어집니다.
-
집 값을 예측하는 데에 사용되는 집의 특성들은 properties file에 주어집니다.
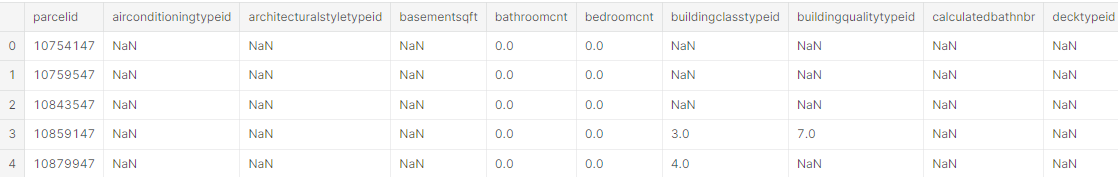
57가지의 특성들이 있으며, 우선은 이 중에서 float 타입의 column들을 살펴보려고 합니다.
numpy의 corrcoef 함수를 사용하여, float type column들과 target value인 log error 의 선형 상관관계를 표현해봅시다.
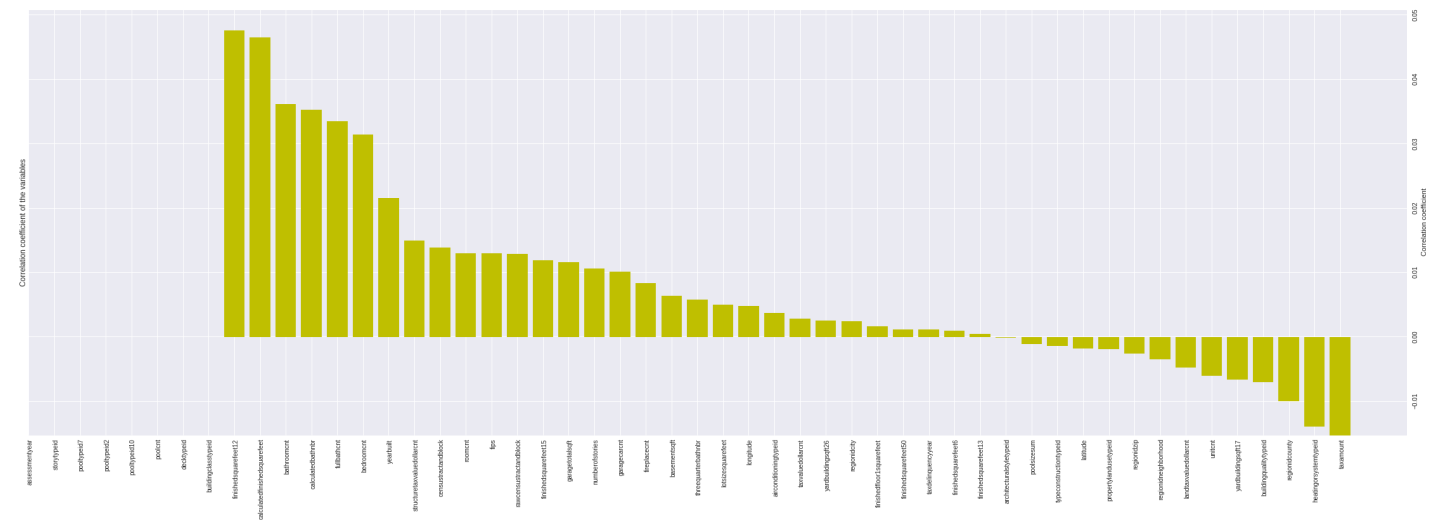
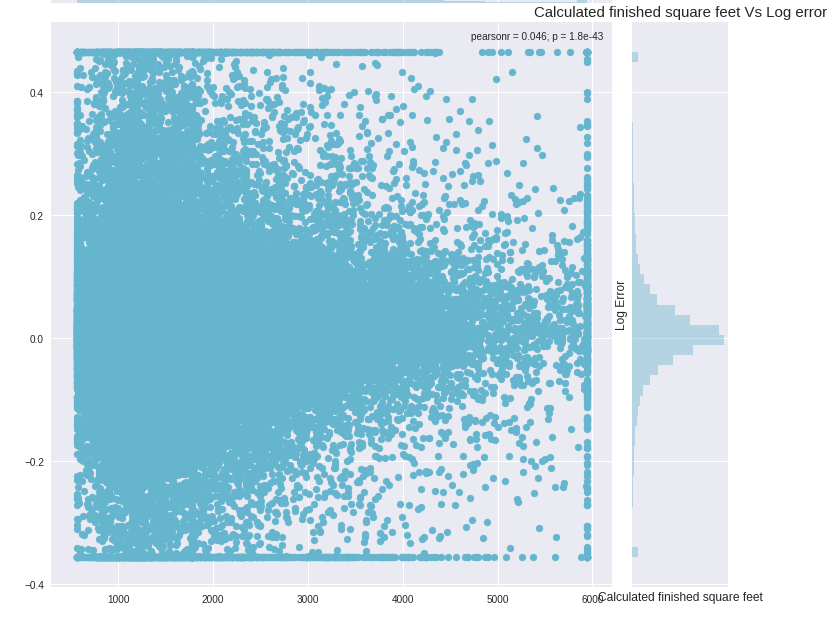
이 중에서 상관관계가 높은 몇 개의 column들에 대해 seaborn의 jointplot을 사용하여 나타내봅시다.
-
하지만, 이러한 방법은 선형적 분석일 뿐만 아니라, 뚜렷한 관계를 발견하기 어려워 important feature를 구하기에는 불충분합니다. 이제 비선형 모델을 사용하여 중요한 column을 구해보겠습니다. 이 커널에서는
1. Extra Tree
2. XGBoost
두 가지 모델을 사용합니다.
그 전에, Bagging과 Boosting의 차이점을 알아봅시다.
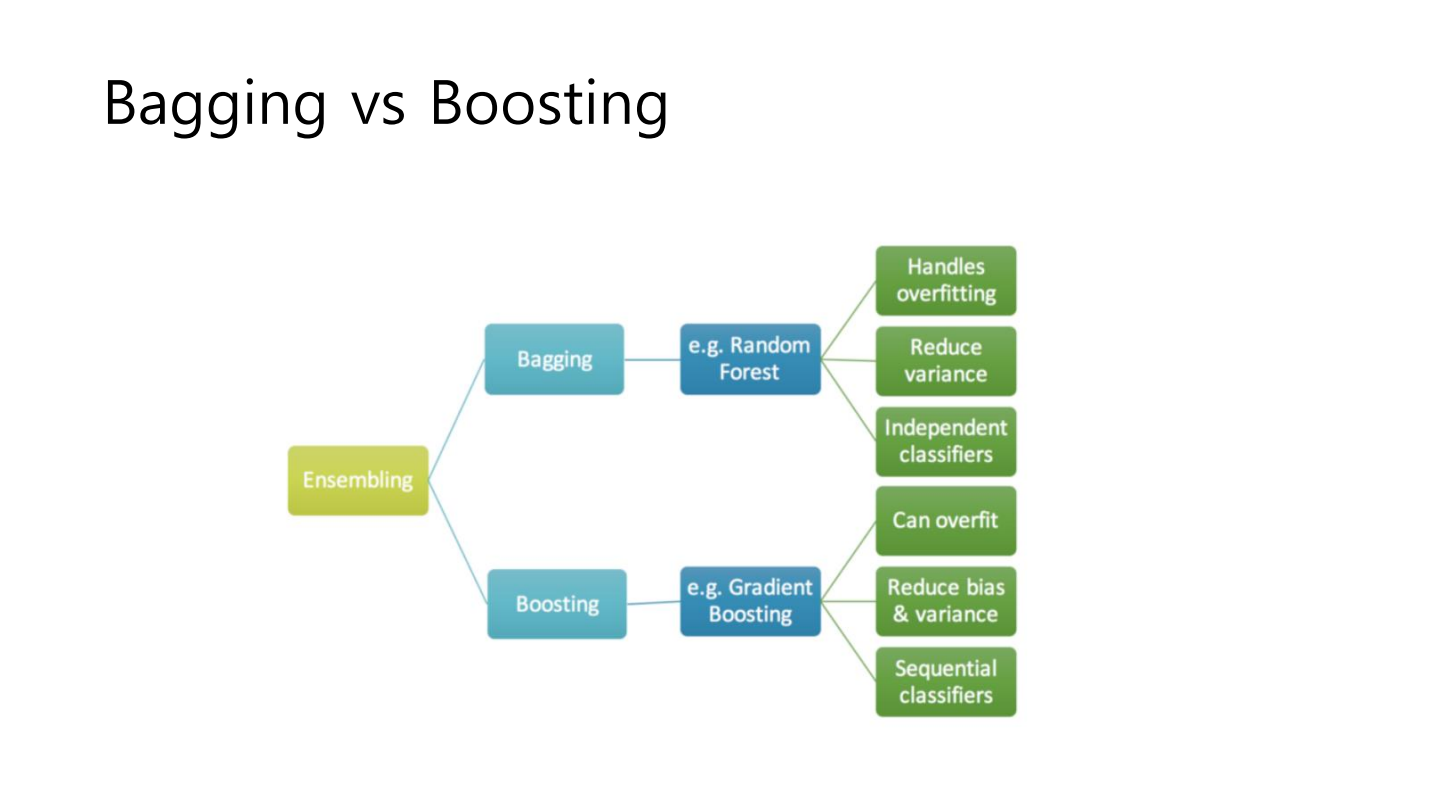
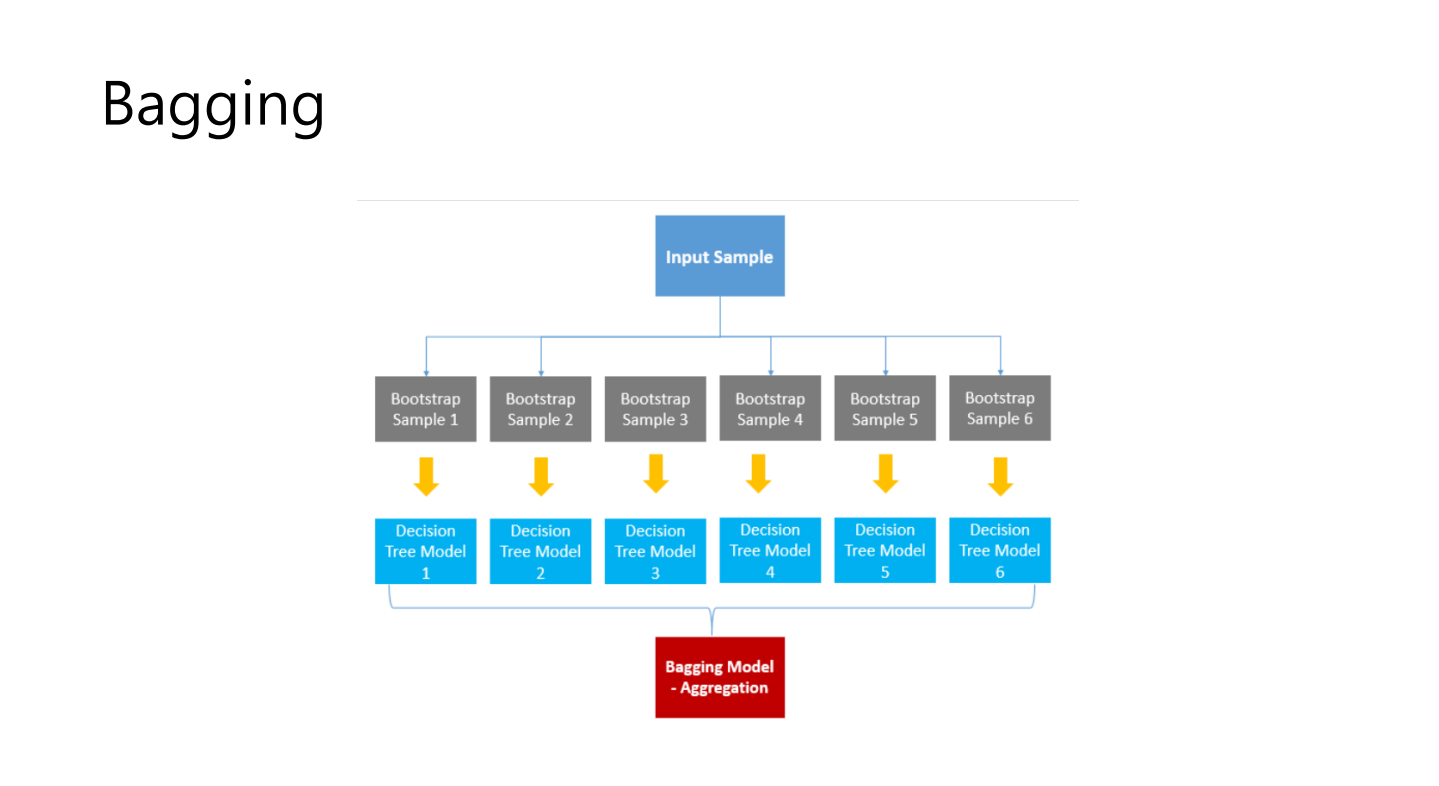
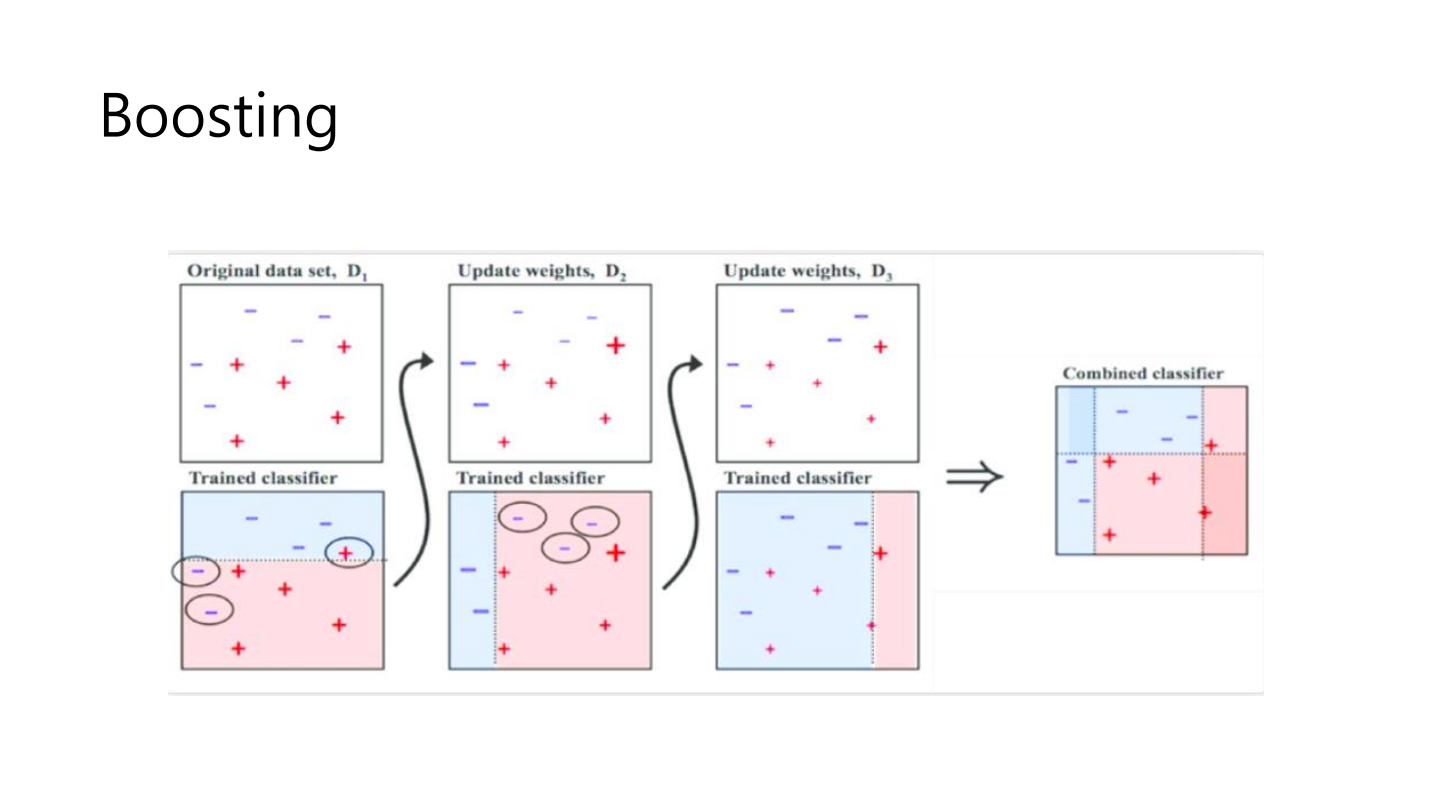
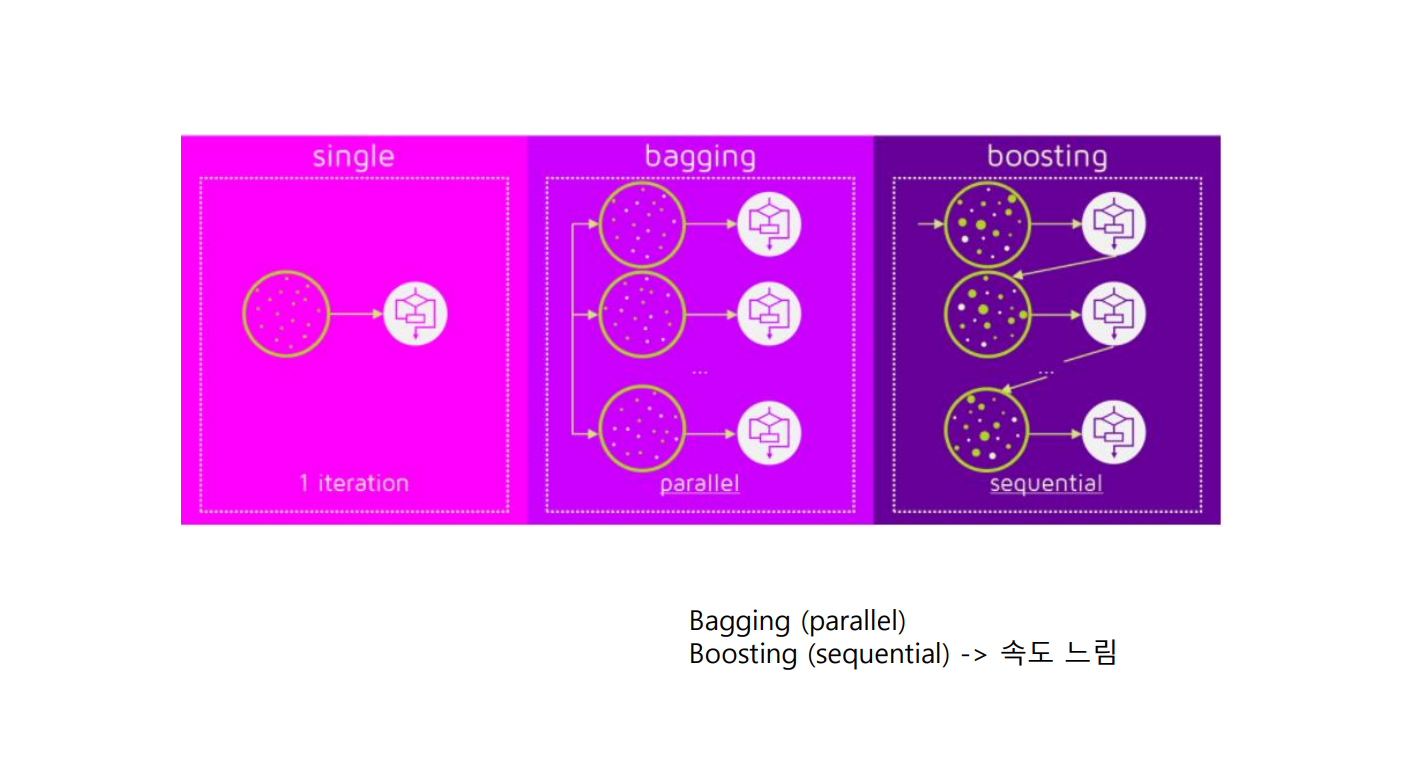
두 기법 모두 Ensemble 기법으로, random sampling을 하지만 Bagging은 각 weak tree들이 서로 독립적인 데에 비해, Boosting은 잘못 학습된 부분에 대해 가중치를 부여하기 때문에 sequential learning을 한다는 점이 가장 큰 차이점입니다.
이제 Bagging의 대표적인 알고리즘인 Random Forest와 비슷하지만 다른 Extra Trees 모델과, Boosting 기법의 Gradient Boosting을 개선한 XGBoost를 사용해봅시다!
-
먼저 Extra Trees 입니다.
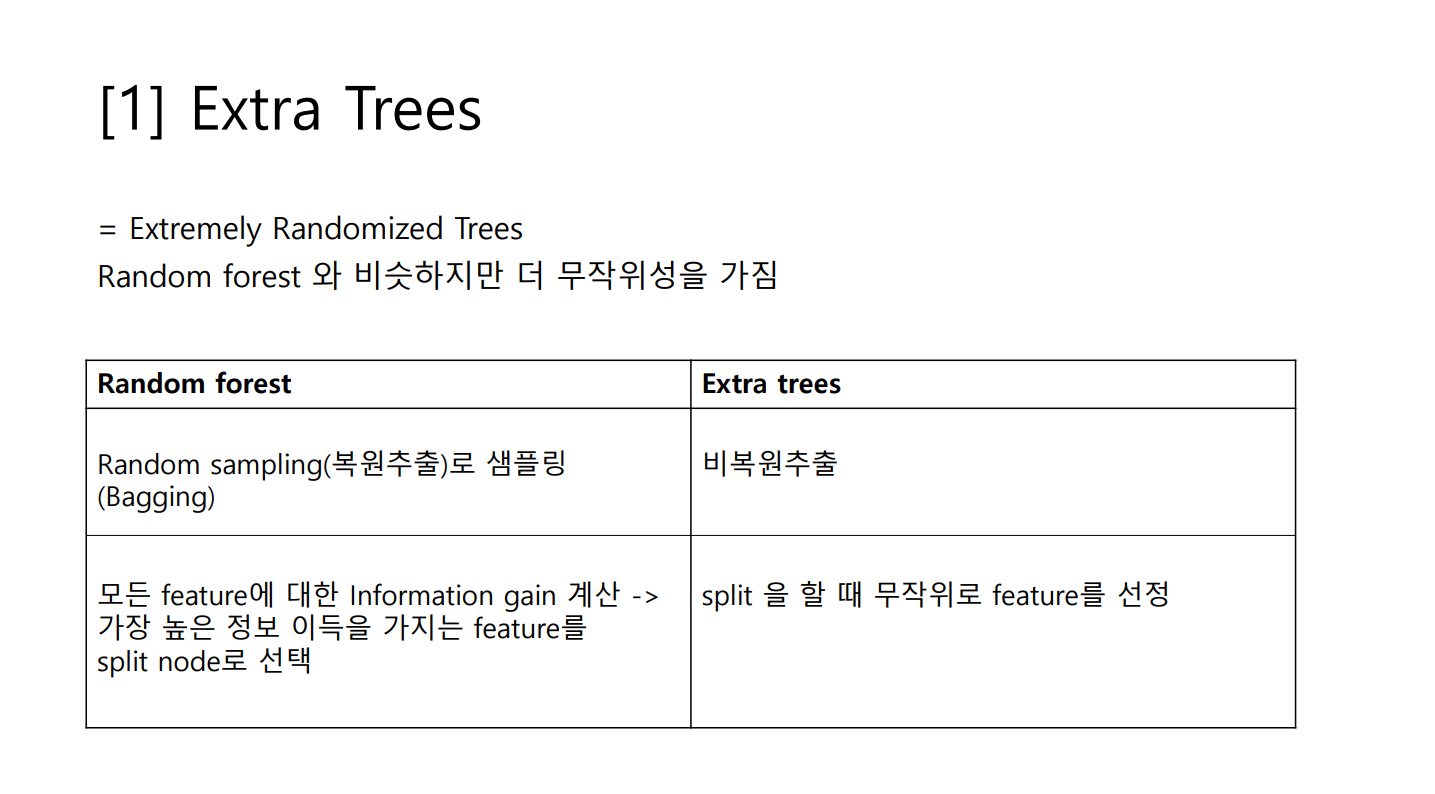
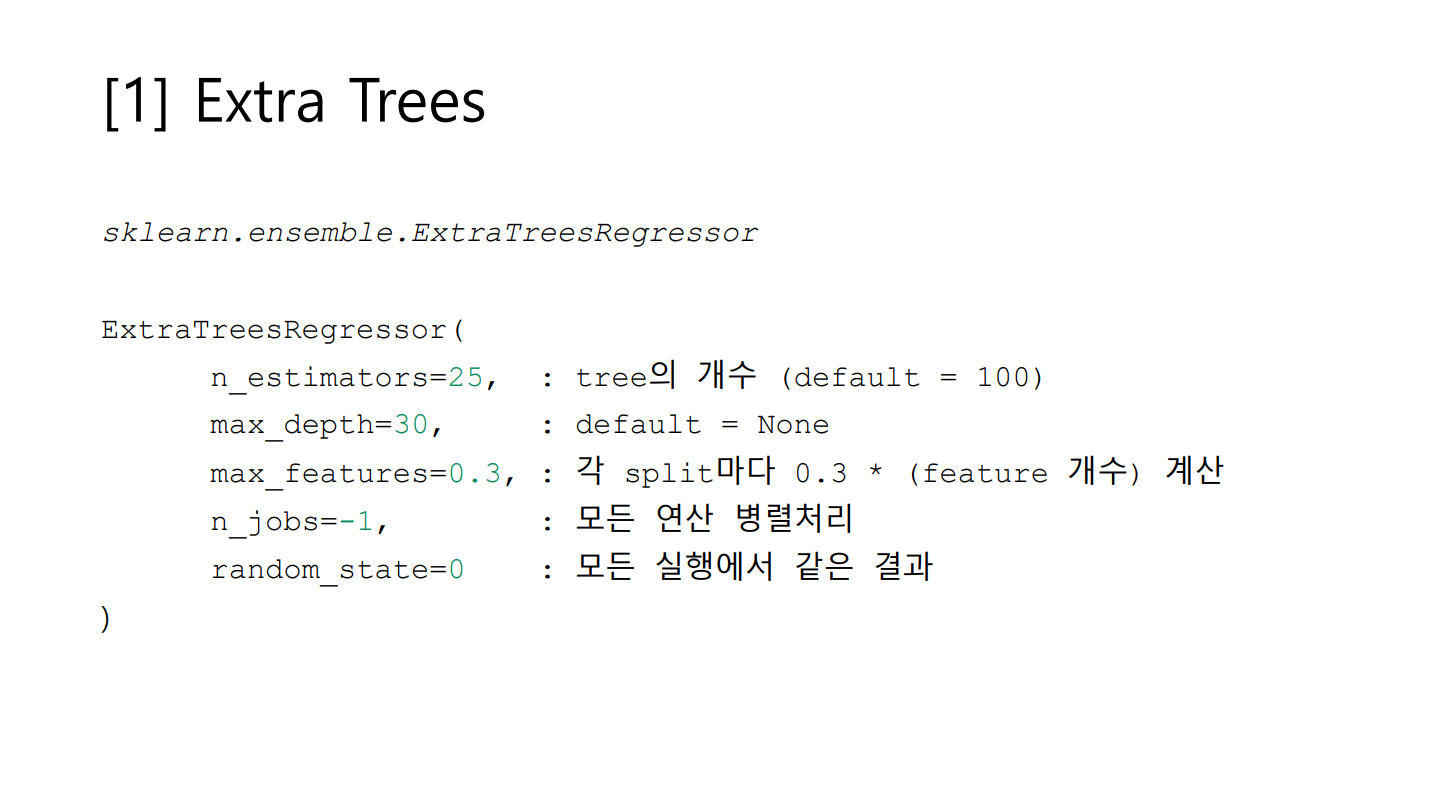
이제 sklearn의 ExtraTreesRegressor 를 사용하여 feature importance를 구해봅시다.
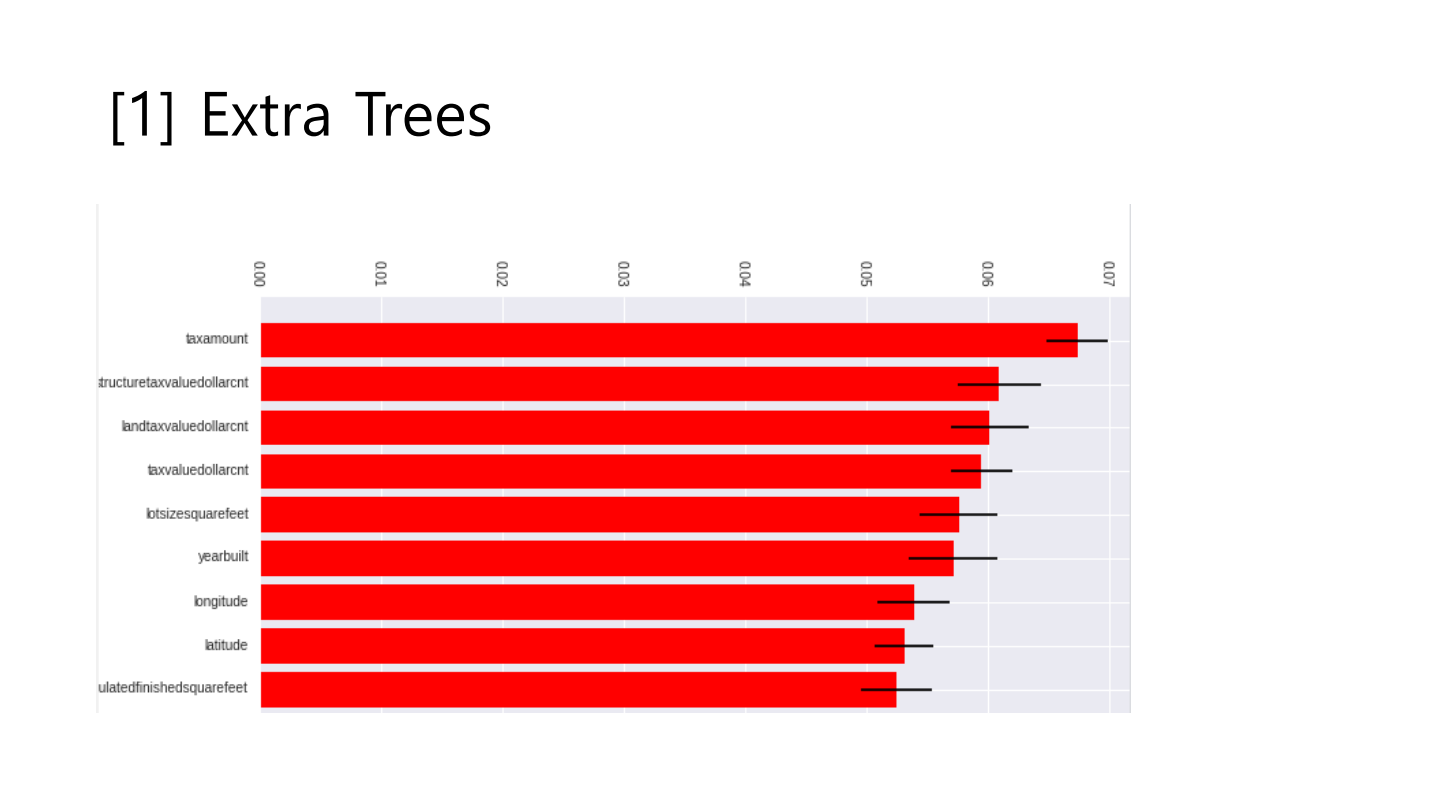
tax 관련 column들이 중요도가 높게 나오네요!
-
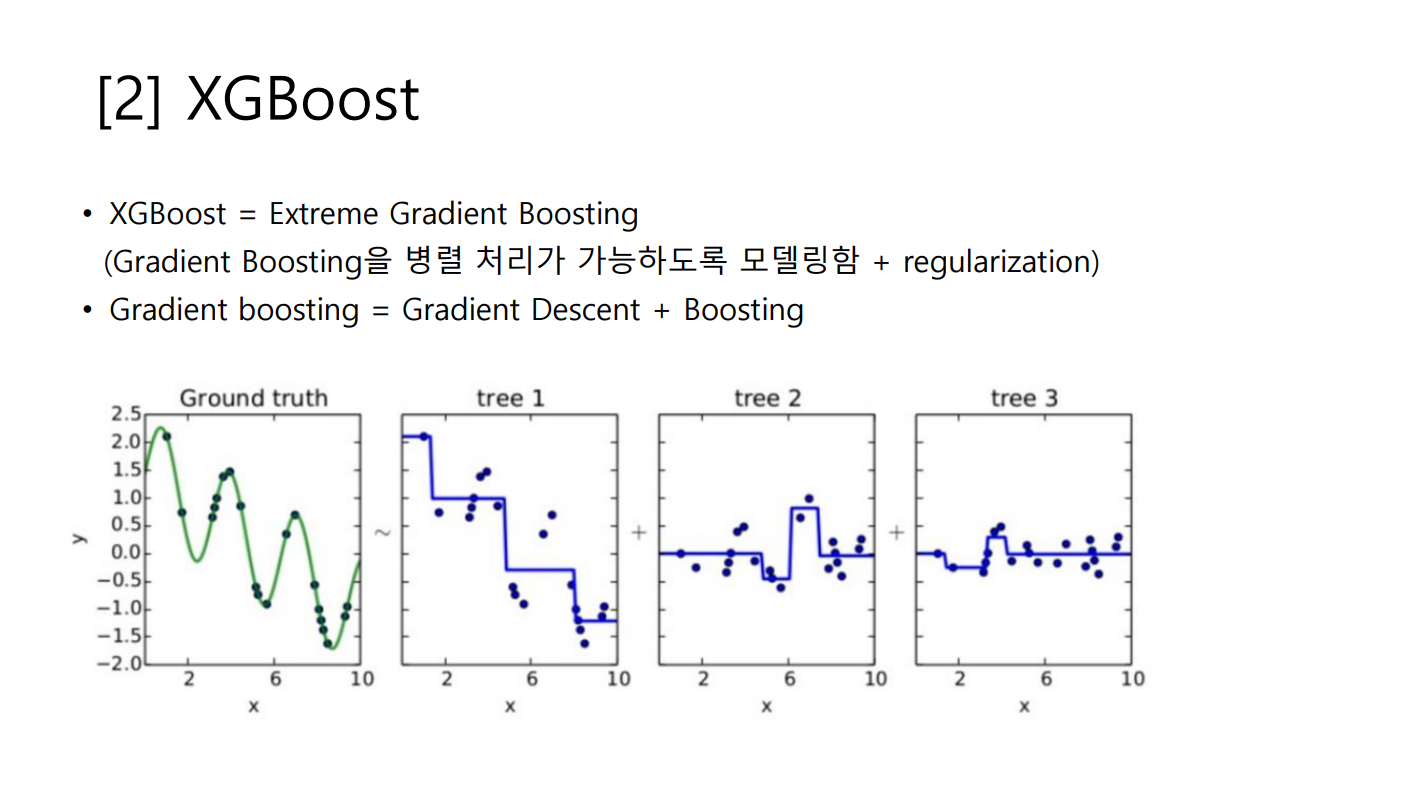
두번째로, XGBoost는 앞서 소개한 대로 Gradient Boosting 을 개선한 모델입니다.
병렬 처리가 가능한 Bagging 기법에 비해 속도가 느린 Boosting이, 병렬 처리가 가능하도록 모델링되었습니다.
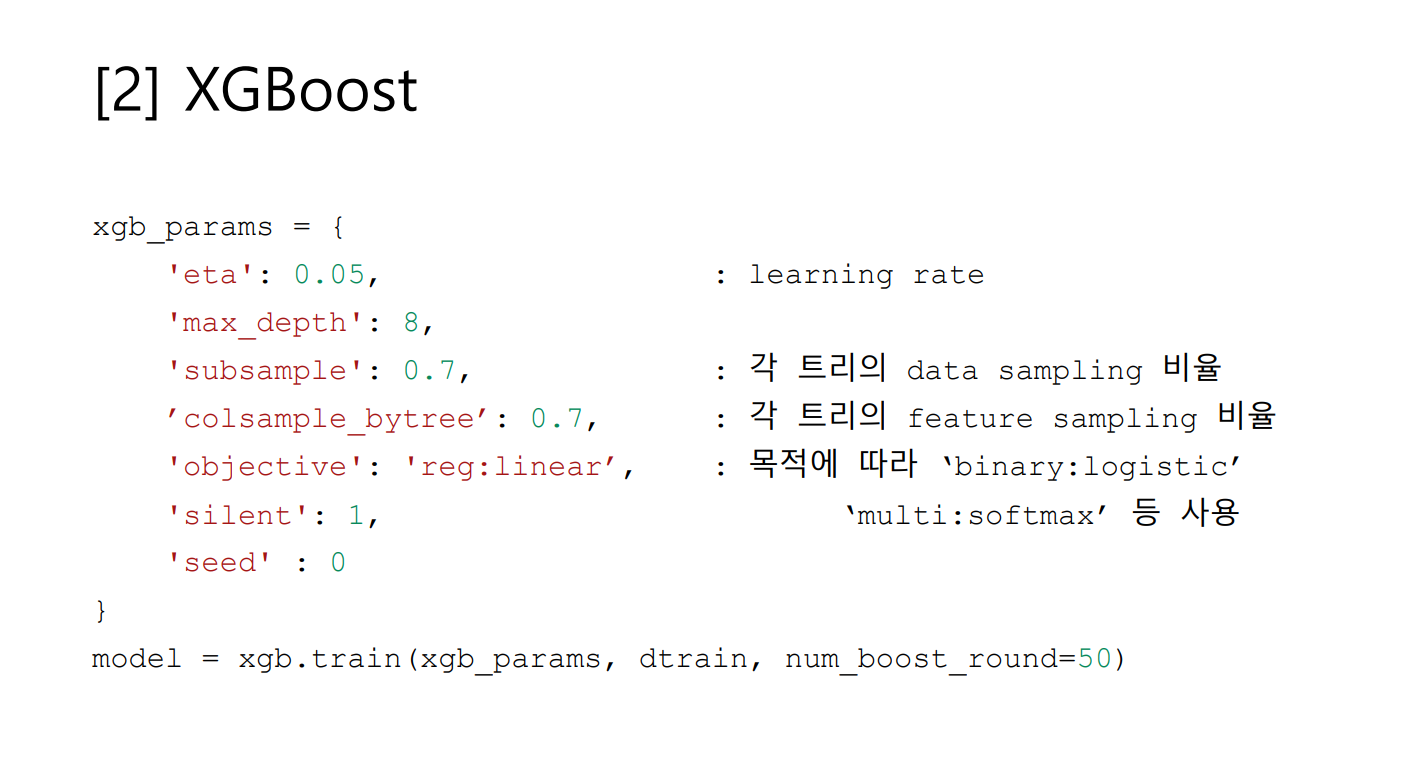
import xgboost 후에 train 함수를 사용했는데요, 이 외에도 XGBRegressor를 사용할 수도 있습니다.
필요한 파라미터들을 넣어주고 feature importance를 구하면
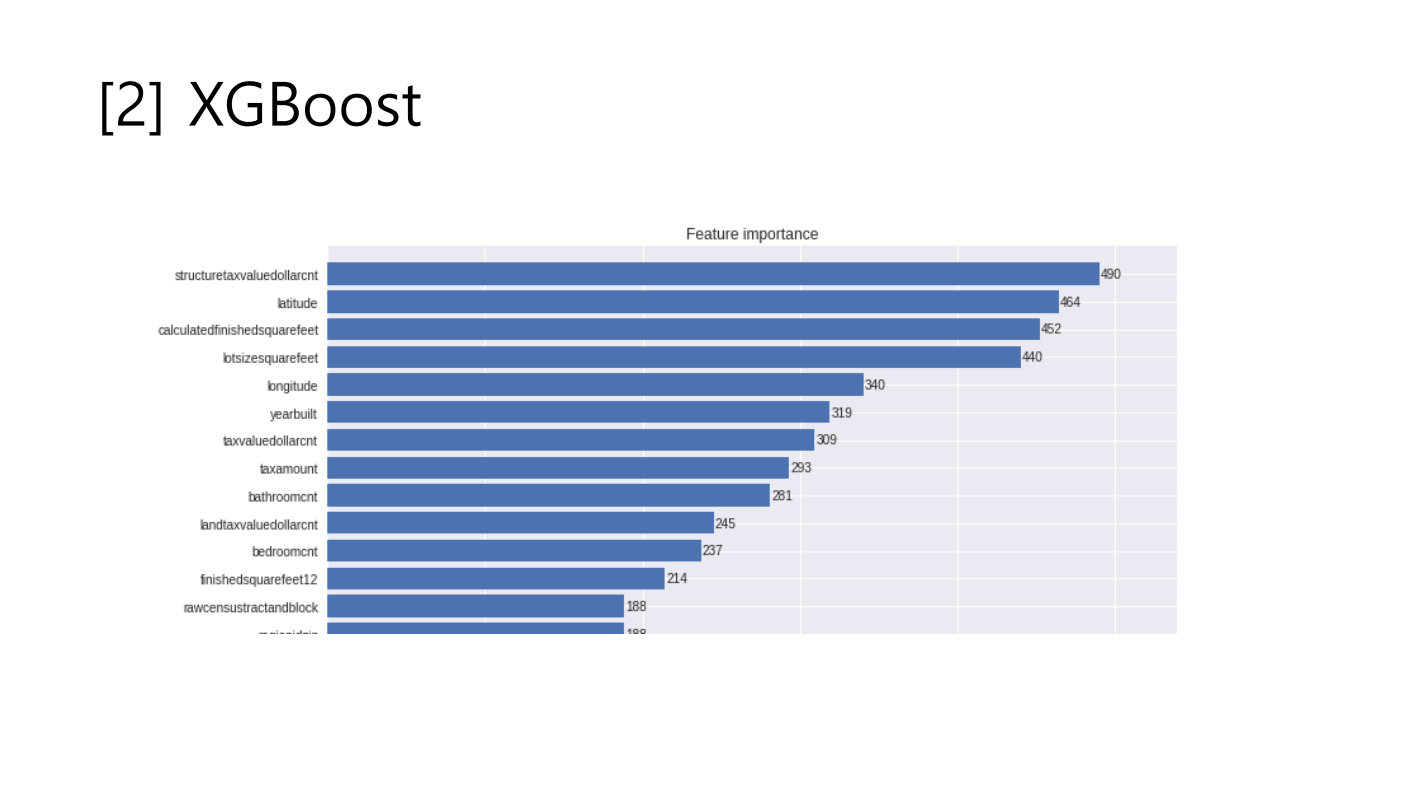
다음과 같은 결과를 확인할 수 있었습니다.
'3-1기 스터디 > 캐글 필사' 카테고리의 다른 글
| [8주차] TensorFlow Speech Recognition Challenge (0) | 2021.12.23 |
|---|---|
| [7주차] Statoil/C-CORE Iceberg Classifier Challenge (0) | 2021.12.04 |
| [5주차] Dynamics of New York city - Animation (0) | 2021.11.17 |
| [4주차] Costa Rican Household Poverty Level Prediction (0) | 2021.11.14 |
| [3주차] 자동차 보험회사 데이터분석 (0) | 2021.11.07 |


댓글